01 / NEDEN BU KONU ÖNEMLI?
Neden Bu Konu Önemli?
İki controller bulunan bir Aruba wireless cluster'da AP'lerin iki cihaza dağılmış olması tek başına sağlıklı bir tasarım anlamına gelmez.
Örneğin şöyle bir dağılım düşünelim:
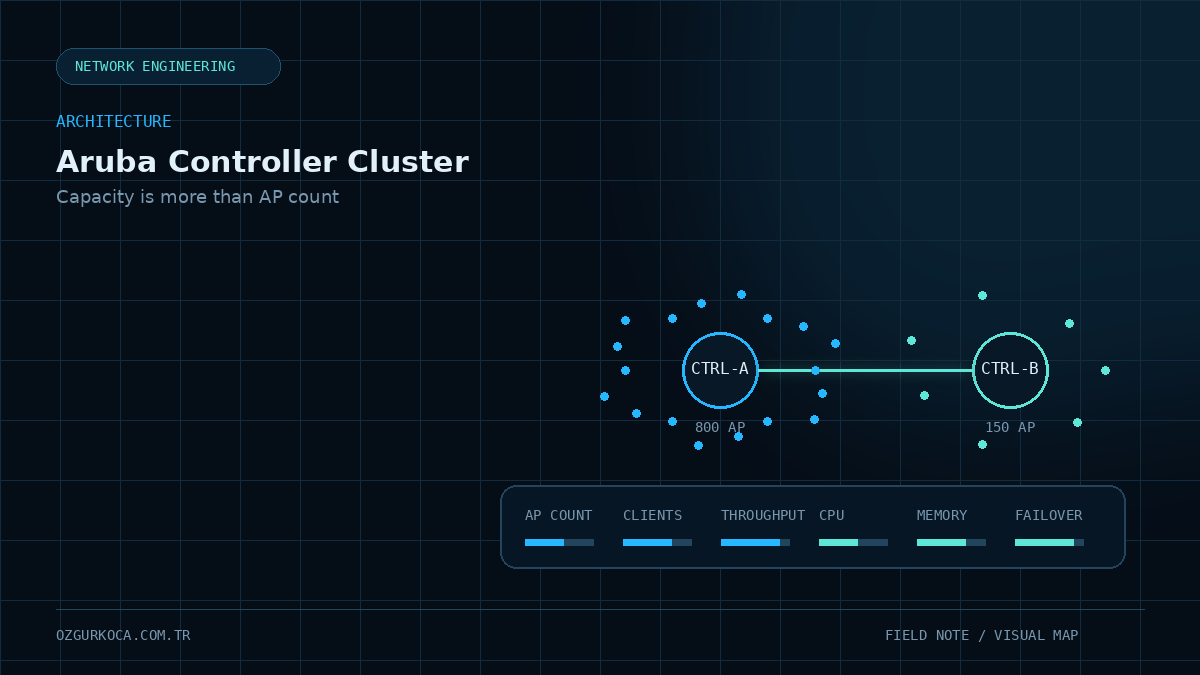
Controller-A  ->  800 AP
Controller-B  ->  150 AP
Bu yapı çalışıyor olabilir; ancak yükün büyük bölümü tek controller üzerinde toplanmıştır. Böyle bir durumda yalnızca AP sayısı değil, istemci yoğunluğu, trafik ve cihaz kaynakları da birlikte değerlendirilmelidir.
Bu nedenle cluster değerlendirmesinde temel soru şudur:
AP'ler iki controller arasında nasıl görünüyor? sorusundan önce, yük gerçekten dengeli mi ve bir controller kaybolursa kalan cihaz bu yükü taşıyabilir mi? sorusu sorulmalıdır.
02 / AP SAYISI EŞIT OLSA BILE YÜK EŞIT OLMAYABILIR
AP Sayısı Eşit Olsa Bile Yük Eşit Olmayabilir
İki controller üzerinde aynı sayıda AP olması ilk bakışta dengeli görünebilir:
Controller-A  ->  300 AP
Controller-B  ->  300 AP
Ancak AP'lerin taşıdığı gerçek yük farklı olabilir.
Örneğin:
Controller-A
  300 AP
  Normal ofis kullanımı

Controller-B
  300 AP
  Daha yoğun kullanıcı trafiği
  Video konferans
  Yüksek istemci sayısı
AP sayısı eşit olmasına rağmen ikinci controller daha fazla iş yapıyor olabilir.
Bu nedenle yalnızca AP Count değil, aşağıdaki metrikler birlikte takip edilmelidir:
| Metrik | Ne anlatır? |
|---|---|
| AP Count | Controller üzerindeki AP sayısı |
| Client Count | Controller'ın taşıdığı gerçek istemci yoğunluğu |
| Throughput | Üzerinden geçen trafik miktarı |
| CPU | İşlem yükü |
| Memory | Kaynak kullanımı |
| AP Type | Farklı AP tiplerinin oluşturabileceği kapasite ve kullanım farkları |
Kısacası:
AP sayısı bir dağılım göstergesidir; gerçek yükü tek başına göstermez.
03 / ACTIVE-ACTIVE YAPIDA HEDEF NE OLMALI?
Active-Active Yapıda Hedef Ne Olmalı?
İki controller bulunan bir cluster'da cihazlardan birini sürekli çok yoğun kullanıp diğerini neredeyse boş bırakmak kaynakların verimsiz kullanılmasına neden olabilir.
Dengesiz örnek:
Controller-A  ████████████████  yoğun
Controller-B  ███               düşük yük
Daha sağlıklı hedef:
Controller-A  ████████          dengeli yük
Controller-B  ████████          dengeli yük
Buradaki amaç matematiksel olarak tam %50 / %50 elde etmek değildir. Asıl amaç, AP ve istemci yükünün gereksiz şekilde tek controller üzerinde birikmesini önlemektir.
Böylece:
- Her iki controller'ın kaynakları kullanılır.
- CPU ve memory yükü daha dengeli izlenebilir.
- Tek cihaz üzerinde gereksiz yoğunluk oluşmaz.
- Failover davranışı daha öngörülebilir hale gelir.
04 / ASIL KAPASITE TESTI FAILOVER ANIDIR
Asıl Kapasite Testi Failover Anıdır
Normal durumda iki controller yükü paylaşabilir:
             Aruba Cluster

       Controller-A     Controller-B
            |                |
          400 AP            400 AP
Controller-A devre dışı kaldığında ise durum değişir:
             Aruba Cluster

       Controller-A     Controller-B
           DOWN              |
                           800 AP
Bu noktada asıl tasarım sorusu ortaya çıkar:
Kalan controller, bütün AP ve istemci yükünü kabul edilebilir performansla taşıyabiliyor mu?
Bu nedenle kapasite planlamasında yalnızca normal çalışma durumu değil, tek controller kaybı da hesaba katılmalıdır.
Kontrol edilmesi gereken başlıklar:
- Controller'ın desteklediği AP kapasitesi
- Gerekli lisans kapasitesi
- Client yoğunluğu
- CPU kullanımı
- Memory kullanımı
- Trafik / throughput yükü
05 / BASIT BIR FAILOVER KONTROLÜ NASIL DÜŞÜNÜLMELI?
Basit Bir Failover Kontrolü Nasıl Düşünülmeli?
Cluster tasarımını değerlendirirken aşağıdaki basit akış kullanılabilir:
Normal çalışma yükünü ölç
          |
          v
AP + Client dağılımını incele
          |
          v
Bir controller'ı kayıp kabul et
          |
          v
Tüm yük kalan controller'a geçtiğinde
kapasite yeterli mi?
          |
       +--+--+
       |     |
      EVET  HAYIR
       |     |
       v     v
   Tasarım  Kapasite / dağılım
   uygun    yeniden değerlendirilmeli
Bu yaklaşım, yalnızca mevcut durumun güzel görünmesine değil, arıza durumunda sistemin davranışına odaklanır.
06 / AP'NIN HANGI CONTROLLER'A BAĞLANDIĞINI BILMEK NEDEN ÖNEMLI?
AP'nin Hangi Controller'a Bağlandığını Bilmek Neden Önemli?
AP dağılımını analiz ederken AP'lerin controller'ları nasıl bulduğunu ve hangi controller'ı tercih ettiğini de bilmek gerekir.
İncelenebilecek başlıklar arasında:
- LMS
- Backup LMS
- Cluster üyeleri
- AP discovery mekanizması
- DHCP tabanlı discovery
- DNS tabanlı discovery
bulunur.
Amaç, bir AP yeniden başladığında veya bağlantısını yeniden kurduğunda beklenmeyen şekilde farklı bir controller üzerinde toplanıp toplanmadığını anlamaktır.
Örneğin normalde dengeli görünen bir yapı, çok sayıda AP'nin yeniden başlamasından sonra zaman içerisinde şöyle bir dağılıma dönüşebilir:
Controller-A  ->  700 AP
Controller-B  ->  200 AP
Bu nedenle yalnızca anlık AP sayısına değil, AP'lerin controller seçme davranışına da bakmak gerekir.
07 / DENGESIZLIK GÖRÜLDÜĞÜNDE HEMEN REBALANCE YAPILMALI MI?
Dengesizlik Görüldüğünde Hemen Rebalance Yapılmalı mı?
Her dengesizlik otomatik olarak müdahale edilmesi gereken bir problem değildir.
Örneğin:
Controller-A  ->  700 AP
Controller-B  ->  200 AP
görüldüğünde ilk refleks AP'leri hemen yeniden dağıtmak olabilir. Ancak önce gerçek etkisi kontrol edilmelidir.
Gerçek performans problemi var mı?
             |
             v
CPU veya memory baskısı var mı?
             |
             v
Client yoğunluğu dengesiz mi?
             |
             v
Failover kapasitesi risk altında mı?
Rebalance kararı verilirken operasyonel etkiler de değerlendirilmelidir:
- Kullanıcı kesintisi oluşur mu?
- AP'lerin yeniden bağlanması gerekir mi?
- İşlem hangi bakım aralığında yapılacak?
- Kablosuz kullanıcı deneyimi etkilenir mi?
- Fiziksel lokasyon bazında yeni bir dengesizlik oluşur mu?
Bu nedenle:
Rebalance işleminin amacı yalnızca iki taraftaki AP sayılarını güzel göstermek olmamalıdır.
08 / RF VE FIZIKSEL LOKASYON DAĞILIMINI UNUTMAYIN
RF ve Fiziksel Lokasyon Dağılımını Unutmayın
Controller yükünü değerlendirirken AP'lerin fiziksel olarak nerede bulunduğu da önemlidir.
Örneğin aynı binadaki AP'lerin büyük kısmı tek controller üzerinde toplanmış, diğer controller ise farklı lokasyonlardaki AP'leri taşıyor olabilir.
Bu durumda yalnızca controller tarafındaki metriklere bakmak yeterli değildir. Failover veya yeniden dağılım sonrasında kablosuz ortam da gözlemlenmelidir.
Değerlendirilebilecek başlıklar:
- AP'lerin fiziksel lokasyon dağılımı
- RF domain yapısı
- Kanal / RF optimizasyon davranışları
- Kullanıcı yoğunluğunun lokasyonlara göre dağılımı
- AP'lerin yeniden bağlantı davranışı
Buradaki amaç, controller tarafında yapılan bir değişikliğin kablosuz kullanıcı deneyimine etkisini de gözden kaçırmamaktır.
09 / ÖNCE CLUSTER SAĞLIĞI, SONRA AP DAĞILIMI
Önce Cluster Sağlığı, Sonra AP Dağılımı
AP dağılımı beklenmedik görünüyorsa bunun nedeni her zaman kapasite veya load balancing olmayabilir.
Örneğin aşağıdaki durumlar mevcutsa AP dağılımı da sağlıklı görünmeyebilir:
- Cluster health problemi
- Peer bağlantı problemi
- Bir node'un izole durumda olması
- Synchronization problemi
Bu nedenle analiz sırası şu şekilde olmalıdır:
Cluster Health
      |
      v
Peer Connectivity
      |
      v
Synchronization
      |
      v
Node Status
      |
      v
AP / Client Distribution
Cluster sağlığı bozukken görülen AP dağılımını doğrudan kapasite problemi olarak yorumlamak yanıltıcı olabilir.
10 / PRATIK İZLEME TABLOSU
Pratik İzleme Tablosu
Cluster'ı düzenli takip ederken basit bir tablo oldukça işe yarar:
| Kontrol | Controller-A | Controller-B | Failover Sonrası |
|---|---|---|---|
| AP Count | İzle | İzle | Kalan node toplamı taşıyabiliyor mu? |
| Client Count | İzle | İzle | Peak client sayısı uygun mu? |
| Throughput | İzle | İzle | Tek node trafik yükünü karşılıyor mu? |
| CPU | İzle | İzle | Failover sonrası kabul edilebilir mi? |
| Memory | İzle | İzle | Failover sonrası yeterli mi? |
| Cluster Health | Sağlıklı olmalı | Sağlıklı olmalı | Peer / sync durumu kontrol edilmeli |
Bu tablo sayesinde yalnızca mevcut dağılımı değil, arıza senaryosunu da aynı değerlendirmeye dahil etmek mümkün olur.
11 / TASARIM KONTROL LISTESI
Tasarım Kontrol Listesi
12 / EN KRITIK ÇIKARIM
En Kritik Çıkarım
Bu konuyu tek cümlede özetlemek gerekirse:
AP load balancing, AP sayılarını eşitlemek değildir. Asıl hedef, controller'lardan biri kaybedildiğinde kalan controller'ın AP, istemci ve trafik yükünü sorunsuz şekilde taşıyabilecek kapasitede olmasıdır.
Örneğin aşağıdaki görünüm tek başına yeterli değildir:
Controller-A  ->  400 AP
Controller-B  ->  400 AP
Gerçek test şudur:
Controller-A DOWN
       |
       v
Controller-B
       |
       +-- Tüm AP'ler
       +-- Tüm client yükü
       +-- Artan throughput
       |
       v
CPU + Memory + Capacity
       |
       v
Sistem kararlı mı?
13 / SONUÇ
Sonuç
Aruba controller cluster tasarımında AP dağılımı yalnızca AP sayısına bakılarak değerlendirilmemelidir.
Sağlıklı bir analiz için birlikte izlenmesi gereken temel başlıklar:
AP Count
+ Client Count
+ Throughput
+ CPU
+ Memory
+ Cluster Health
+ Failover Capacity
Normal durumda dengeli görünen bir cluster'ın gerçek dayanıklılığı, controller'lardan biri devre dışı kaldığında ortaya çıkar.
Bu nedenle iyi bir tasarımın hedefi sadece yükü paylaşmak değil, aynı zamanda tek node kaybında hizmeti sürdürebilecek kapasiteyi korumaktır.
Bu içerik faydalı oldu mu?
Tek tıkla görüşünü bırak. Geri bildirimler yeni içerikleri ve mevcut rehberleri geliştirmek için kullanılır.